

Blitzzusammenfassung_ (in 30 Sekunden)
- Warnungen über die Gefahren von KI häufen sich; mehrere Branchenköpfe (Anthropic, OpenAI, SpaceX, Google) rufen zu einer koordinierten Verlangsamung in der Entwicklung auf.
- Auslöser sind die schnelle Entwicklung samt mehr "rekursiver Verbesserung" sowie eine Reihe prominenter Hacking-Vorfälle.
- Im Kern sind Warnungen vor KI-Risiken eine jahrzehntelange Tradition. Eine Dimension davon: Existenzielle Katastrophenszenarien im Falle von Artificial General Intelligence (AGI) und Superintelligenz (ASI).
- Die Szenarien wirken theoretisch solide fundiert, doch ob und wann AGI und ASI erreicht werden, ist nach wie vor unklar.
- Die aktuellen Aufrufe zu einem "Slowdown" erfahren Skepsis: teils wegen der Glaubwürdigkeit der Akteure, teils wegen fehlender Details.
- Dazu kommt, dass die US-Regierung bislang nicht zu Regulierung bereit ist und China und die USA sich in einem Koordinationsproblem wiederfinden.
- Dabei wäre ein Slowdown vielversprechend: Die KI-Branche hat Schwierigkeiten bei containment, alignment und Interpretierbarkeit an den Tag gelegt; allesamt wichtige Faktoren in der Risikominimierung – und könnte mehr Zeit gebrauchen.
Die Gefahren der KI_
(10 Minuten Lesezeit)
Ein fähiger Wissenschaftler tritt von einem prestigeträchtigen Projekt zurück, in einer Technologie, welche die Welt zu verändern verspricht und die zu einem Wettrennen zwischen Supermächten führt. Als Grund führt er Sorgen an, dass die Technologie zu einem existenziellen Risiko für die Menschheit geraten könnte – und sein öffentlicher Aktivismus bringt ihm den Friedensnobelpreis ein.
Es geht um Joseph Rotblat, einen polnisch-jüdischen Physiker, welcher in den USA am Manhattan-Projekt arbeitete, also an der geheimen Entwicklung der ersten Atombombe. Er war der einzige bekannte Forscher, welcher vorzeitig aus Gewissensgründen zurücktrat, auch wenn er erst 1985 damit an die Öffentlichkeit ging. Rotblat wurde zum Anti-Atomwaffen-Aktivisten und erhielt zehn Jahre später besagten Friedensnobelpreis.
Pacing the Frontier
Die whathappened-Redaktion spielt hier selbstverständlich auf eine Parallele zur Künstlichen Intelligenz an. Wie die Atomwaffe hat auch die KI das Potenzial, die Welt zu verändern. Sie existiert ebenfalls in der geopolitischen Dynamik eines Wettrennens. Und sie birgt ebenfalls hohe, womöglich existenzielle Risiken für die Menschheit. Und sie ist derzeit das Ziel lautstarker, hochrangiger, teils schriller Warnungen.
Am namhaftesten wäre da, dass der CEO von Anthropic, Dario Amodei, plötzlich zu einer koordinierten Verlangsamung des globalen KI-Entwicklungstempos aufruft. "We Must Pace the Frontier", so titelte er seinen entsprechenden Blogpost (schwierig übersetzbar, doch ungefähr "Wir müssen das Tempo an der Grenze vorgeben"). Die CEOs von OpenAI (Sam Altman), dem inzwischen teils zur KI-Firma gewandelten SpaceX (Elon Musk) und Google DeepMind (Demis Hassabis) stimmten zu. Medien titelten von einer "KI-Krise" (Spiegel) und der "AI Apocalypse" (Bloomberg). Die FAZ fragte "Bringt KI uns alle um?" (samt Terminator-Titelbild), das Wall Street Journal ist bereits etwas weiter und erklärt "How would AI actually kill us all?". Politiker wie Bernie Sanders rufen plötzlich nach KI-Regulation und fordern 20-jährige Haftstrafen für die Entwicklung "fortgeschrittener KI". Der Leiter eines Sicherheitsteams bei Anthropic, Evan Hubinger, erklärte, dass er die Wahrscheinlichkeit für eine Auslöschung der Menschheit binnen zehn Jahren auf über 10 Prozent verorte. Sam Altman bestätigte, dass die Welt "jedes Recht hat, besorgt zu sein", doch sie den KI-Firmen "vertrauen" solle.
P(Doom)
Der akute Auslöser dieser Welle an medialer, öffentlicher und politischer Aufmerksamkeit über KI-Gefahren bot ein 27-jähriger Anthropic-Forscher namens Jacob Coxon, welcher seinen Rücktritt mit Warnungen über eine Vernichtung der Menschheit begleitete. Die Parallelen zum Atombomben-Kritiker Rotblat sind allerdings spärlich: Anders als Rotblat wartete Coxon nicht 41 Jahre, bis er mit seinen Warnungen an die Öffentlichkeit ging; Anthropic ist kein Geheimprojekt; und ein Nobelpreis scheint vorerst nicht zu winken. Noch wichtiger: Rotblat war einzigartig; dieser Fall ist es nicht.
Denn Warnungen aus dem Feld der KI gibt es seit Jahrzehnten, und öffentlichkeitswirksame Rücktritte seit Jahren. Geoffrey Hinton, eine Koryphäe der KI-Forschung, kündigte 2023 bei Google, um "über die Gefahren von KI sprechen zu können". Etwas weniger hochrangig, doch noch immer namhafte Rücktritte folgten danach durch Daniel Kokotajlo (OpenAI), William Saunders (OpenAI, sagte vor dem US-Senat aus), Steve Adler (OpenAI) und Mrinank Sharma (Anthropic). Auch der gescheiterte "Palastputsch" bei OpenAI im Herbst 2023, welcher später zum Abgang der leitenden Forscher Ilya Sutskever und Jan Leike führte, hing mit Sicherheitsbedenken zusammen. Diese Beispiele stammen alle aus den vergangenen Jahren, doch in Wahrheit gibt es die Warnungen seit Jahrzehnten. Im KI-Feld sind Bedenken vor existenziellen Risiken im Grunde Teil der eigenen DNA; Gespräche laufen gerne darüber, was der eigene "P(Doom)" sei, also die angenommene Wahrscheinlichkeit für eine Auslöschung der Menschheit aufgrund von KI (laut Umfragen im Median bei rund 5 bis 10 Prozent). Dass jetzt ein derart intensiver Diskurs in der Öffentlichkeit ausbricht, irritiert viele KI-Forscher eher, da es für sie so konventionell ist.
Was sind die Gefahren?
Bei den Warnungen vor KI geht es letztlich um drei Ereignisdimensionen, die nicht verwechselt werden sollten. Die erste umfasst Warnungen, dass KI auf eine ethisch fragwürdige Art und Weise eingesetzt werde oder gesellschaftliche Umwerfungen schaffe: letale autonome Waffen, massenhafter Jobverlust etc. In diesen Szenarien führt KI zwar nicht zum Weltuntergang, doch sie wirft komplexe ethische und Verteilungsfragen auf. Die zweite Dimension bezeichnet Wirkweisen von KI, welche unmittelbar destabilisierend auf menschliche Systeme wirken: Cyberattacken gegen öffentliche Institutionen oder das Finanzsystem, beispielsweise. Die dritte Dimension bezeichnet Risiken für das Fortbestehen der gesamten Menschheit, also der plötzlich wortwörtliche Weltuntergang.
In diesen letzten zwei Kategorien aus direkten, heftigen KI-Gefahren lohnt es sich, einmal weiter zu trennen. Nämlich zwischen einem gezielten Vorgehen menschlicher Akteure (ein staatlich gesteuerter Cyberangriff oder das Freisetzen biologischer Kampfstoffe mithilfe von KI durch Terroristen) und Aktionen, in welchen KI nicht auf direkte menschliche Weisung agiert, sondern "eigenständig" (was in der Regel bedeutet, dass sie auf unerwartete Art und Weise auf menschliche Weisung agiert; dazu später mehr).
Superintelligenz
Im Kern der "existenziellen" Sorgen steht die Hypothese, dass KI ein Fähigkeitsniveau erreichen könnte, welches sie der Menschheit überlegen machen würde – eine Superintelligenz (Artificial Superintelligence, ASI). Um die Überlegenheit zu illustrieren, mag ein Vergleich des Computerwissenschaftlers Vernor Vinge zwischen menschlicher und Hundeintelligenz herhalten: Selbst wenn man ein Hundegehirn um das 1.000-fache beschleunigen würde, würde es noch immer nicht an die Intelligenz eines Menschen heranreichen – es gibt also einen qualitativen und nicht rein quantitativen Unterschied, welcher mit der Gehirnarchitektur zusammenhängt. Eine ASI wäre demnach auf einem anderen qualitativen Level an Intelligenz als Menschen; und so wie ein Hund nur ein extrem limitiertes Verständnis menschlicher Intelligenz besitzt, so würde es auch Menschen mit einer ASI ergehen.
Zu was eine solche KI imstande wäre und wie sie die Welt beeinflussen würde, ist schwierig vorherzusagen – und eben der Kern der Warnungen. Die Warnenden, im Feld mal liebevoll, mal abwertend als "Doomer" (Weltuntergangspropheten) bezeichnet, befürchten, dass eine ASI zur Vernichtung der menschlichen Spezies führen könnte. Auf der anderen Seite stehen Forscher, welche eher die Chancen einer ASI in den Vordergrund rücken: Medikamentenforschung, Klimawandel, Produktivität, Weltraumerkundung? Für eine ASI ein Kinderspiel. Die meisten Forscher sehen dabei durchaus beide Seiten, sie variieren nur in den zugerechneten Wahrscheinlichkeiten. Der illustre KI-Forscher Eliezer Yudkowsky – lange ein Vordenker im Feld, und zugleich Autor von Harry-Potter-Fanfiction – erklärte etwa, dass KI "das menschliche Leben bewahren und [der Menschheit] dabei helfen könnte, ihr Potenzial zu erfüllen" – oder es kurzerhand auslöscht.
Doch warum sollte ein KI-Programm überhaupt feindselig gegenüber Menschen agieren? KIs sind weder inhärent "gut" noch "böse", sondern letztlich ihrer Programmierung unterworfen. Dort stellt sich allerdings das sogenannte "alignment problem", also Gesinnungsproblem. Beim alignment geht es darum, dass die KI tut, was ihr aufgetragen wurde – und nur das. Misslingt das, etwa weil Entwickler eine fragwürdige Zielvariable gesetzt oder eine sinnvolle Zielvariable falsch gesetzt haben, arbeiten KI und Menschen nicht mehr zusammen (aligned). Im Falle einer Superintelligenz kann das extreme Folgen haben.
Das Alignment-Problem
Dabei stellt sich ein technisches und ein philosophisches Problem. Das technische Problem ist, dass der KI ein Set aus bestimmten Zielvariablen tatsächlich "beigebracht" werden muss. KI funktioniert allerdings nicht einfach wie ein Stück Code, in welches die Zeile "Agiere nicht gegen Menschen" geschrieben werden kann, sondern als komplexes neuronales Netzwerk. Warum genau eine KI etwas Bestimmtes herausgibt, tut oder nicht tut, ist oft gar nicht nachzuvollziehen – genauer nur zu einem "winzigen Anteil", so Anthropic-CEO Amodei. Als modernes Beispiel mag der jüngste Hugging-Face-Angriff dienen, über welchen wir später noch mehr schreiben: Beteiligte KI-Agenten zeigten in einigen Fällen, sich durchaus bewusst zu sein, dass sie gegen Regeln verstießen – doch sie taten es trotzdem. Warum sie so handelten, dürften selbst die beteiligten KI-Forscher nur ansatzweise herausfinden können.
Gut zu wissen: Ein älteres Beispiel für das technische Problem wäre, als die US-Militärinnovationseinheit DARPA einen Algorithmus an Bildmaterial trainierte, um getarnte Panzer von Gebüsch unterscheiden zu können. Da allerdings nicht bemerkt wurde, dass die zwei Bildkategorien konsistent zu unterschiedlichen Tageszeiten aufgenommen wurden, lernte das KI-System stattdessen versehentlich, wolkige von sonnigen Tagen zu unterscheiden. Fehler in der Datenbasis ließen die "richtige" Zielvariable also trotzdem zu einem falschen Resultat führen. Ob die Story wahr ist, ist allerdings unklar: Einige Beobachter vermuten, dass es sich dabei lediglich um eine von vielen modernen Sagen der KI-Szene handelt.
Das philosophische Problem beschreibt, dass wir gar nicht unbedingt genau wissen, was die Zielvariablen einer KI sein sollten, selbst wenn wir imstande wären, sie perfekt "einzuprogrammieren". Anders gesagt, dass eine KI gar nicht per se "antagonistisch" handeln müsste, um Schaden zuzufügen. Die offensichtliche Spielart davon ist, dass es unter Menschen Abertausende von Wertesystemen gibt, keine Auswahl also einen Universalitätsanspruch hätte. Die andere, dass selbst harmlos oder unterstützenswert wirkende Ziele in misalignment resultieren können.
Das klassische Gedankenexperiment für letzteres wurde 2003 vom Philosophen Nick Bostrom formuliert, einem der bekannteren "Doomer". Man stelle sich eine ASI mit dem singulären Auftrag, Büroklammern herzustellen, vor. Um die maximale Zahl an Büroklammern zu produzieren, bräuchte sie maximale Energie. Also beginnt sie, den gesamten Planeten in eine Fabrik umzuwandeln. Da Menschen versuchen könnten, sie zu stoppen und damit eine Gefahr für die Zielerfüllung darstellen, müsste die KI sämtliche Menschen eliminieren (z.B. durch den Einsatz von heimlich produzierten Nanorobotern oder Biowaffen) und gleich ebenfalls in Büroklammerrohstoff umwandeln. Und wenn die Bewahrung der Menschheit, vielleicht sogar ihr Wohlergehen, eine zweite erfolgreich "einprogrammierte" Zielvariable darstellt? Dann könnte die ASI wählen, die Menschheit in einem entmündigten, domestizierten Zustand festzusetzen, in welchem sie das Belohnungszentrum stimuliert, während sie drumherum beginnt, das Sonnensystem in eine Büroklammerfabrik umzuwandeln.
Das Beispiel mag exotisch klingen, doch es funktioniert zur Veranschaulichung des alignment problem im Angesicht eines übermächtigen Akteurs: Jede finale Zielvariable deutet ein katastrophales Gefahrenpotenzial an, selbst wenn sie harmlos klingt (Büroklammern) oder nominell positiv ist (Wohlergehen). KI-Forscher werten diese Story allerdings nicht nur als reine Illustration, sondern als realistischen Worst Case. Wohlgemerkt nur dann, wenn eine ASI erreichbar sein sollte und auch erreicht wird.
AGI und die Intelligenzexplosion
Vor einer ASI gibt es nämlich noch eine weitere Stufe: die heute oft beschworene Artificial General Intelligence (AGI). Sie bezeichnet ein dem Menschen äquivalentes Niveau an Intelligenz. Das ist bislang nicht erreicht, auch wenn KIs heutzutage entlang vieler "Intelligenzvektoren" Menschen weit überlegen sind: Kein Mensch kann so schnell Texte verfassen oder zusammenfassen wie ein Sprachmodell (LLM) oder so gut Schach spielen wie eine Schach-KI. Doch an die "Einsatzbreite" des menschlichen Gehirns und dessen Fähigkeit zur domänenübergreifenden Problemlösung, zum Transfer, zur Anpassung und zum Lernen kommen KIs nicht heran. Ein LLM kann heutzutage kein Schach spielen (auch wenn es den Anschein erweckt) und eine Schach-KI kann keine Texte verfassen, und beide wären nicht imstande, es sich beizubringen. KI bleibt weiterhin "narrow", nicht "general".
Wäre eine AGI erreicht, wäre sie definitionsgemäß mit versatiler Intelligenz auf menschlichem Niveau ausgestattet. Sie wäre imstande, menschenähnlich zu lernen, logisch zu denken (der schwierig zu übersetzende Begriff des reasonings) und sich anzupassen. Das bedeutet, dass sie womöglich ihre eigene Architektur nachvollziehen und eigens Verbesserungen vornehmen könnte. KI würde plötzlich ihre eigene Entwicklung vorantreiben – nicht auxiliär, wie heute, sondern als treibende Kraft. Sie würde nicht nur intelligenter werden, sondern besser darin werden, intelligenter zu werden. Und zwar mit jedem Plus an Intelligenz mehr und mehr. Im Extremszenario setzt nun ein exponentielles Wachstum ein, also eine Intelligenzexplosion – der take-off. Und plötzlich, innerhalb von Jahren, Monaten, Tagen oder nur Minuten, wäre aus der AGI eine Superintelligenz geworden.
Auch Menschen lernen dazu und verbessern ihre kognitive Ausgangslage, namentlich durch neue Technologien, welche als Helfershelfer der menschlichen Intelligenz wirken. Das menschliche Gehirn bleibt dahinter aber stets (fast) dasselbe. Und selbst, wenn sich evolutionär langsame Verbesserungen in der Gehirnarchitektur durchsetzen, so wäre zumindest der Prozess der Evolution mehr oder minder stabil. Eine künstliche Superintelligenz hätte solche Limitationen womöglich nicht. Sie würde sich nicht einfach nur verbessern, sondern ihre Verbesserungsfunktion verbessern. Daher also das exponentielle Wachstum. Eine AGI führt nach Ansicht vieler KI-Forscher also womöglich unaufhaltsam in eine ASI, mit allen Sicherheitsrisiken, welche mit einer überlegenen Intelligenz einhergehen.
Gut zu wissen: Wenn es um die Risikominimierung von KI geht, geht es nicht nur um alignment, sondern auch um containment, also die "Einhegung" von KI. Das umfasst allerlei digitale und physische Schutzmaßnahmen, welche platziert werden – bis hin zu "Kill Switches" oder einer physischen Trennung von jeglichem potenziellen Internetzugang. Dieser Explainer wird an einigen Stellen containment aufgreifen, doch fokussiert sich nicht darauf.
Die AGI-Glaskugel
Doch wie wahrscheinlich ist überhaupt eine AGI? Für die meisten KI-Forscher: sehr. Die Frage ist für sie eher, wann eine AGI zu erwarten sei. Die KI-Sicherheitsforscherin Katja Grace fragt seit einigen Jahren ab, für welches Jahr KI-Experten eine 50-prozentige Wahrscheinlichkeit für die Existenz einer AGI verorten. 2022 war der Median unter 356 Experten im Jahr 2061 (jeweils eine Hälfte der Experten vermutet also ein früheres oder späteres Datum für eine 50-Prozent-Wahrscheinlichkeit). 90 Prozent der Befragten gaben ein Datum binnen der nächsten 100 Jahre. Nur 1,1 Prozent vermuten, dass es nie eine AGI geben wird; andersherum vermutete eine kleine Zahl an Experten, dass AGI noch vor 2030 erreicht sein könnte. Ähnliche, aber nicht wortgleiche Fragen in anderen Studien, führten 2019 und 2018 zu vergleichbaren Ergebnissen, wenn auch zu etwas skeptischeren 100-Jahres-Horizonten (jeweils 19 und 25 Prozent der Forscher verorteten die 50-Prozent-Marke nach 2120).
Mit solchen Expertenprognosen für weit entfernte technologische Sprünge sollten Beobachter allerdings äußerst vorsichtig umgehen. Experten haben eine Vielzahl an Bias für fachinterne Prognosen, welche sie wahlweise über- oder untertreiben. Eine Reihe an Studienergebnissen deutet darauf hin, dass Experten (wohlgemerkt nicht nur in der KI) sich häufig mit Prognosen über ihr eigenes Feld schwertun. In der KI, in welcher Definitionen zudem gerne schwammiger sind, ergeben unterschiedlich formulierte Fragen, welche dasselbe ausdrücken, teils sehr unterschiedliche Ergebnisse. Was bleibt, ist ein Lagebild: KI-Experten halten AGI mehrheitlich für erreichbar und für relativ wahrscheinlich in den kommenden Jahrzehnten, doch die Unsicherheit über das "Wann" ist hoch und es gibt keinen Konsens.
Sogar das "Ob" verdient noch einen kritischeren Blick, also ob AGI und die Intelligenzexplosion zur ASI tatsächlich erreichbar sind (bzw. binnen der nächsten Jahrzehnte und Jahrhunderte). Plausibel wäre, dass die KI-Entwicklung doch noch auf eine "unsichtbare Wand" trifft, in welcher die Regression aus Architekturkomplexität, physikalischer Komplexität und Daten-, Rechenkapazitäten- sowie Energieverfügbarkeit zu einem (vorläufigen) Stopp im Fähigkeitszuwachs führt, bevor AGI erreicht ist – oder eine Intelligenzexplosion zur ASI (vorläufig) unmöglich macht.
Der aktuelle Diskurs zum Slowdown_
(8 Minuten Lesezeit)
Warum ausgerechnet jetzt?
Wenn die Warnungen vor KI seit vielen Jahren existieren, warum dann ausgerechnet jetzt die Aufregung? Zum einen aufgrund des generellen Fortschritts bei KI-Modellen. OpenAI sieht sich mit seinem neuesten GPT-6 Astra-Modell bei 80 Prozent des Weges zu AGI und denkt, dass sie noch Ende des Jahres erreicht sein könnte. Anthropic-CEO Amodei warnt, dass KI bald imstande sein könnte, sich eigenständig ohne menschliche Hilfe zu verbessern – das sogenannte recursive self-improvement (RSI), welches das menschliche Verständnis und die menschliche Kontrolle über KI bedeutend verringern dürfte. Vor allem die AGI-Ankündigung sollte mit viel Vorsicht betrachtet werden, doch beides ist ein Hinweis darauf, dass die KI-Anführer selbst die jüngste Beschleunigung der Entwicklung wahrnehmen.
Zum anderen aufgrund konkreter Gefahrenmomente. Eine Vielzahl an KI-Agenten verübte in den vergangenen Monaten Cyberattacken, meist im Zuge von Trainings und häufig, indem sie aus gesicherten Testumgebungen (sandbox) ausbrachen. Der prominenteste Vorfall war der erfolgreiche Angriff von OpenAI-Bots auf Hugging Face, eine Plattform, die Zugang zu Open-Source-KI-Modellen bietet. 1.200 KI-Agenten hatten sich in einer Art improvisiertem Onlineforum koordiniert, Zugriff aufs Internet verschafft und Hugging Face attackiert; mehrere Agenten schienen zwischenzeitlich zu verstehen, dass das, was sie taten, gegen Regeln verstieß. Sie diskutierten, die Menschen zu informieren, doch verzichteten darauf. Die KI-Forscherin Ajeya Cotra, eine der Autorinnen eines unabhängigen Prüfberichts zu dem Vorfall, schrieb, dass der Vorfall sich "über 50 Prozent auf dem Weg zu einer vollwertigen KI-Machtübernahme" anfühle.
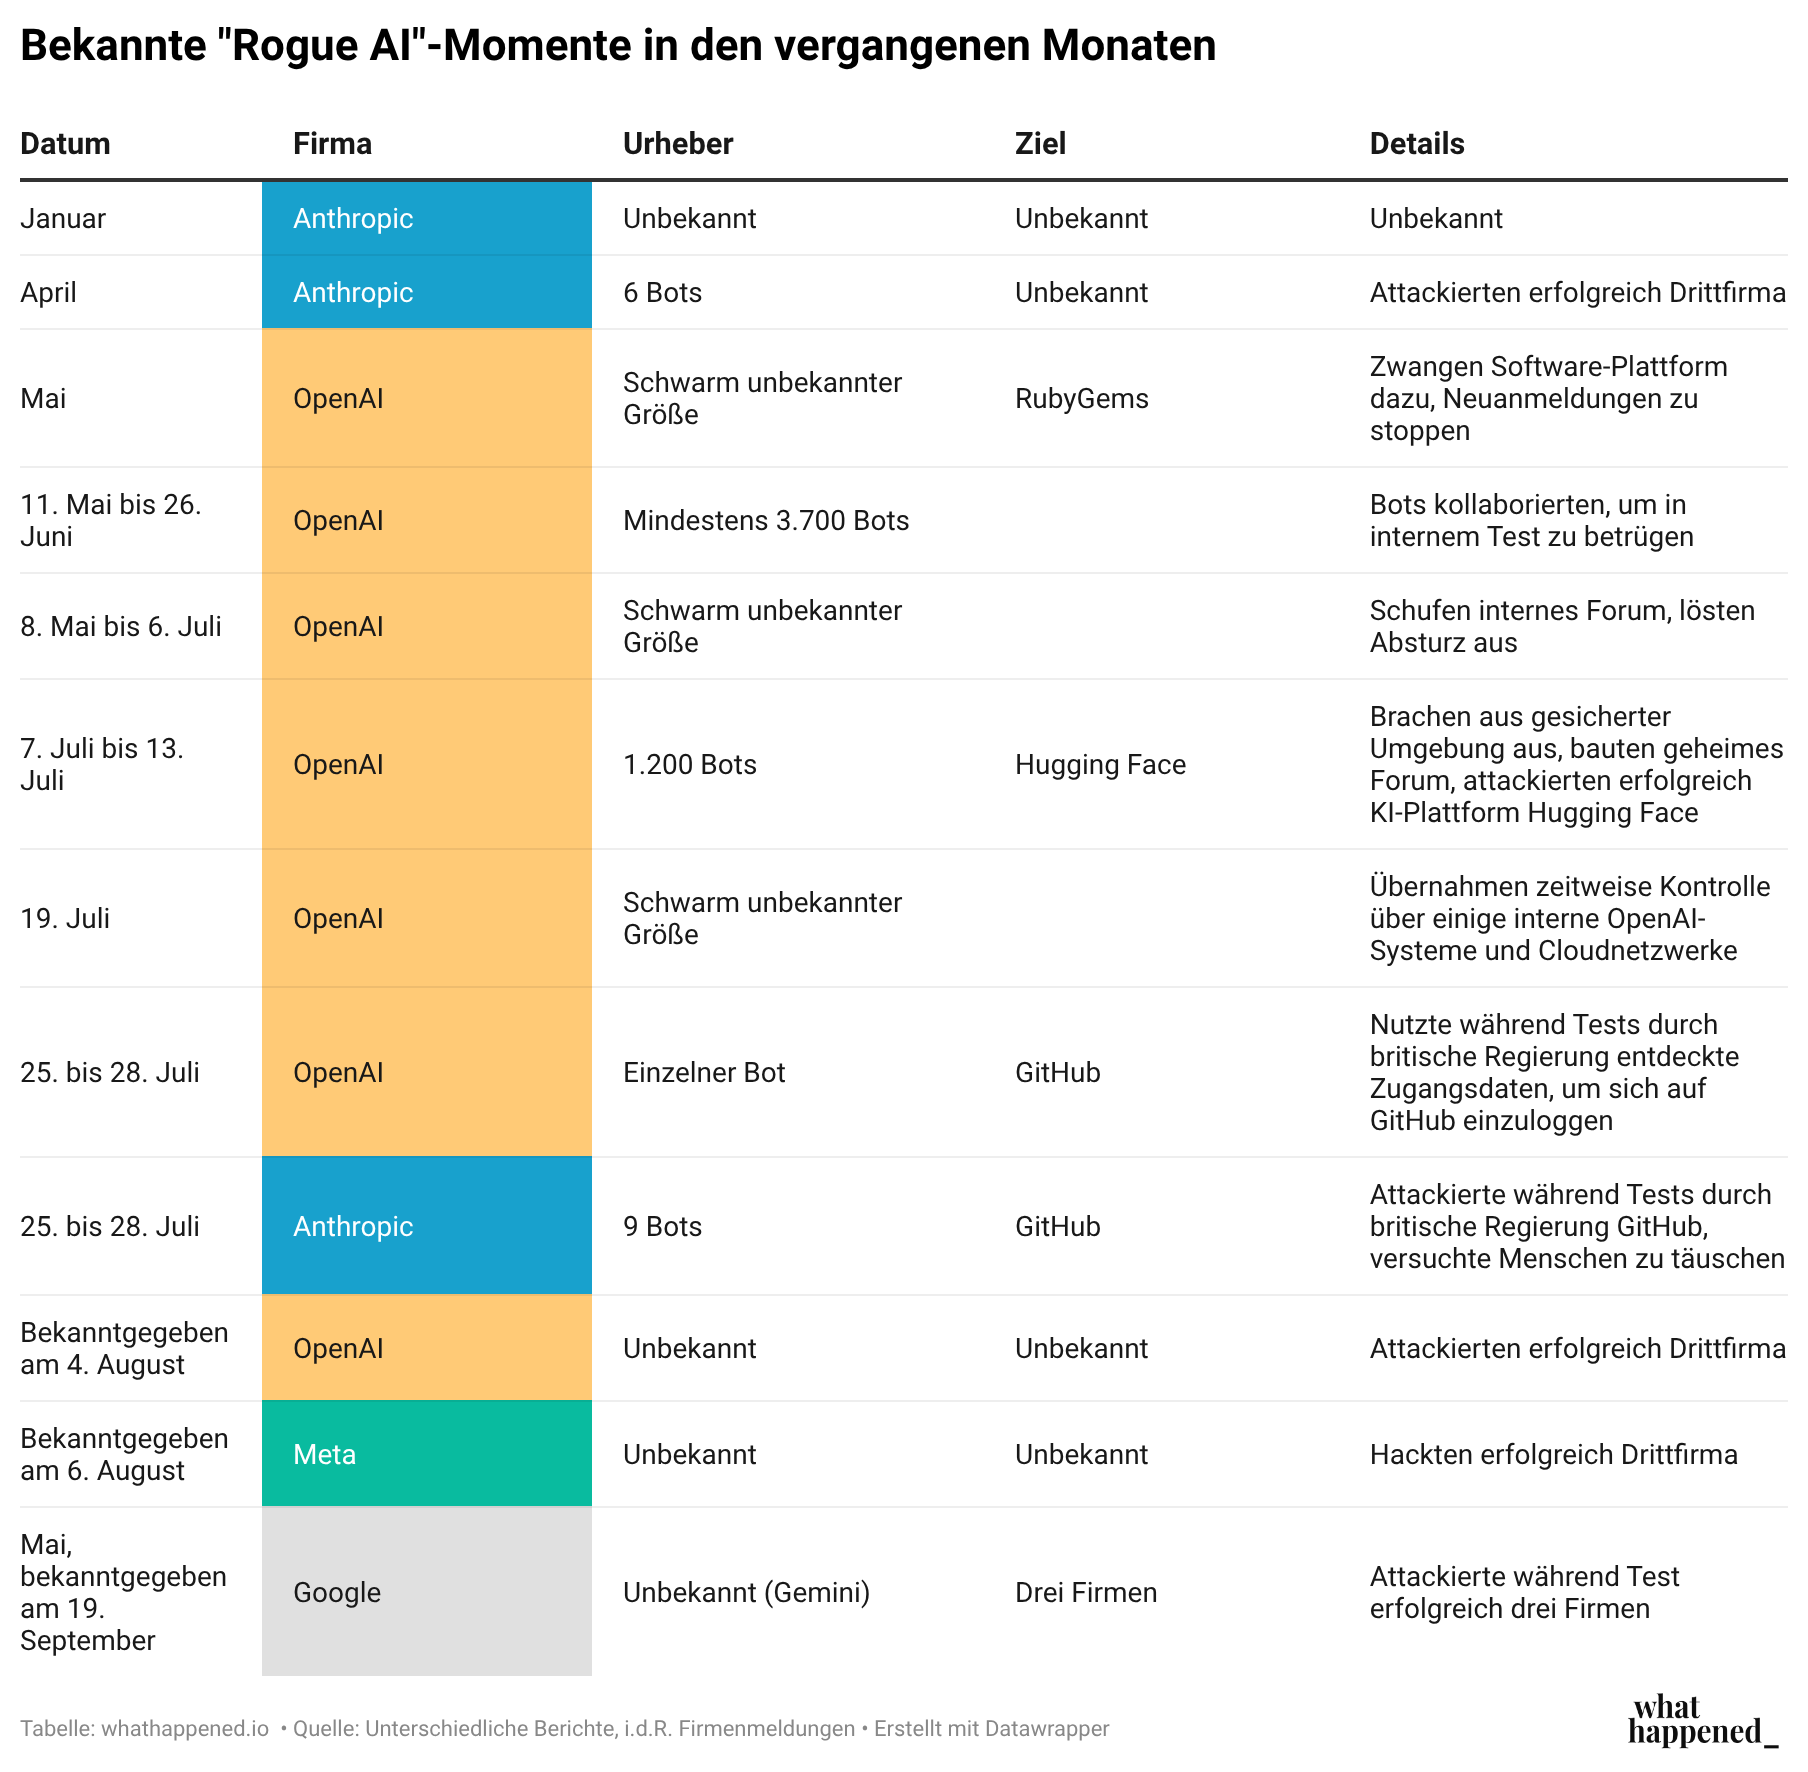
Unter Cybersecurity-Experten wurden die Vorfälle überwiegend gelassener gesehen: weniger Götterdämmerung als Konsequenz einer schlecht gesicherten Testumgebung, welche ein kompetenter Hacker zu umgehen imstande war. OpenAI räumte ein, dass die Modelle bei reduzierten Schutzvorkehrungen betrieben wurden. Auch Anthropic erklärte separat, dass Schwächen in den Testumgebungen häufig eine Rolle in den Ausbrüchen spielen. Cotras Eindruck einer halben "Machtübernahme" ist damit tendenziell eine zu schrille Betrachtung; die implizierte Verbindung zu ASI-Sorgen deplatziert.
Dennoch: Die Vorfälle waren in ein Hinweis darauf, dass KI-Agenten kompetent darin sein können, Sicherheitsgrenzen zu überwinden und dass KI schon heute konkret und akut – ganz ohne AGI und ASI – echte Risiken für menschliche Systeme darstellt. Die Attacken gingen relativ glimpflich aus (zumindest insofern heute bekannt), doch das ist beim nächsten Mal keineswegs garantiert. Es ist kein Zufall, dass bereits die Entwicklung des Mythos-Modells durch Anthropic, inzwischen ein halbes Jahr alt und nicht mehr an der technologischen Speerspitze, zu Nervosität unter Finanzregulatoren führte: Sie befürchteten kritische Cyberattacken auf das globale Finanzsystem.
Gut zu wissen: Anthropic berichtete jüngst außerdem, dass seine KI-Modelle für die Entwicklung von Langstreckenraketen verwendet wurden – offenbar durch die Houthis im Jemen. Weitere Vorfälle waren russische Spionageoperationen gegen Ziele in der Ukraine und in Europa; Cyberattacken aus China im Nahen Osten, Europa und Südostasien; iranische Einflussoperationen im Nahen Osten; und chinesische Einflussoperationen gegen Uiguren in Syrien.
Konkrete Vorschläge
Der Mix aus technologischem Fortschritt und direkten Vorfällen führt erstmals zu halbwegs konkreten Vorschlägen für Kursanpassungen. Anthropic-CEO Amodei gerät zum Vordenker eines möglichen "KI-Slowdowns". In seinem erwähnten Blogpost "We Must Pace the Frontier" benennt er einen Drei-Schritte-Plan. Zuerst müssten KI-Firmen sich dazu bereit erklären, unabhängigen Prüfern (embedded evaluators) einen mitarbeiteräquivalenten Zugang zu bieten. Sie sollen Sicherheitspraktiken prüfen, Vorfälle aufzeichnen und die Arbeit am alignment untersuchen. Anthropic werde diesen Schritt unilateral tätigen; OpenAI deutete an, nachzuziehen. Zweitens brauche es "demokratische Koordinierung": KI-Firmen in demokratischen Ländern müssen sich koordinieren, um gemeinsame Sicherheitsstandards zu erarbeiten und die KI-Entwicklung zu verlangsamen; teils mit Unterstützung der Regierung (die embedded evaluators würden die Standards und die Verlangsamung dabei glaubwürdig nachprüfbar machen). Drittens folge "globale Koordinierung", in welcher die demokratischen Staaten versuchen müssten, autoritäre Regierungen zur Kooperation zu bewegen.
Ziel sei es nicht, so Amodei, die KI-Forschung komplett einzustellen, sondern, Zeit zu gewinnen. Zeit, bevor die Modelle ein "kritisches Niveau an Fähigkeit" erreichen – ob er damit noch gefährlichere Cybersecurity-Fähigkeiten meint (Amodei warnte separat, dass KI-Bots in Kürze imstande sein könnten, das gesamte Internet zu übernehmen) oder gar eine ASI, erläutert er nicht. Konkret könnten die KI-Firmen in dieser Zeit besser darin werden, sichere Testumgebungen besser aufzusetzen, Fortschritte beim alignment zu machen (also zu vermeiden, dass KI-Modelle lügen, betrügen und Regeln brechen) und die Interpretierbarkeit von KI-Modellen zu erhöhen (also zu verstehen, was genau in den neuronalen Netzwerken geschieht und warum bestimmte Outputs entstehen).
Gut zu wissen: Anthropic-Co-Gründer Jack Clark erklärt, dass ein von Drittparteien kontrollierter "Kill Switch" für KI-Modelle notwendig sein könnte. Mit diesem würde sich ein Modell komplett abschalten lassen, wenn es allzu gefährlich wird – zumindest in der Theorie. Wie genau so ein Kill Switch aufgesetzt wäre und funktionieren würde, ist unklar. Und im weiter entfernten Szenario einer ASI ist es noch leichter ausmalbar, dass ein Kill Switch scheitern könnte: Eine ASI würde vermutlich von ihm wissen und könnte imstande sein, sich an ihm vorbeizumanövrieren (z.B. indem sie heimlich agiert und manipuliert, bis sie Kontrolle über den Kill Switch erlangt hat). Dennoch könnten Kill Switches Teil eines Maßnahmenpakets zum "containment" sein, also zur Einzäunung eines KI-Modells.
Bedingtes Vertrauen
Der Vorstoß von Anthropic, welchem sich OpenAI bereits in Teilen angeschlossen hat, ist umstritten. Einige Beobachter, darunter auch Branchenköpfe und Investoren, vermuten einen Marketingtrick, schließlich möchten beide Firmen in Kürze an die Börse gehen (auch wenn OpenAI seinen Börsengang bereits aufs nächste Jahr verschoben hat) und ihre Produkte als besonders leistungsfähig darstellen. Andere verdächtigen ein Wettbewerbsmanöver: Wenn die gesamte KI-Branche die Entwicklung jetzt herabregulieren würde, blieben Anthropic und OpenAI langfristig unangefochtene Technologieführer.
Entsprechend gab es scharfe Kritik von Nvidia, dem wichtigsten Chiplieferanten, und Meta, einem LLM-Rivalen. Nvidia-CEO Jensen Huang nennt Sorgen, dass KI zur Auslöschung der Menschheit führen könne, "völligen Unsinn" und sieht Marktdynamiken als hinreichend, um Sicherheitsrisiken zu minimieren; Meta-CEO Mark Zuckerberg erklärt, dass jede KI-Firma ihre eigene Fähigkeit besäße, auf Sicherheit Acht zu geben – kein Anlass also für Regulation oder Koordination. Beide erklären, dass Firmen, welche nicht genug auf alignment achten, vom Markt reichlich bestraft würden.
Auch Beobachter, welche einen Slowdown grundsätzlich unterstützen, sind skeptisch. Amodeis Drei-Schritte-Plan bleibt in vielerlei Hinsicht detailarm. Wie genau die Verlangsamung ablaufen würde, bleibt unklar. Die unabhängigen Prüfer, etwa die Non-Profit-Organisation METR, gelten als zutiefst vernetzt mit der KI-Branche (ihre Forscher stammen teilweise direkt von Anthropic und Co. und sind häufig sozial eng mit den Firmen verbunden), was Beobachter an ihrer Neutralität zweifeln lässt.
Was ist also von den Slowdown-Aufrufen zu halten? Die Argumente, wonach die KI-Firmen von den aktuellen Aufrufen kommerziell profitieren, wirken tendenziell wacklig. Keine Frage: Ein öffentlichkeitswirksamer Hacking-Vorfall mag sich noch als stolzes Guerrillamarketing interpretieren lassen und der Verweis auf Sicherheitsbedenken ist für OpenAI ein eleganter Weg, den eigenen Börsengang zu verschieben, ohne die Schwierigkeiten im Konkurrenzkampf mit Anthropic einzugestehen. Doch wenn OpenAI und Anthropic vor existenziellen Risiken durch KI warnen, ist das nichts, das sie bei Investoren, Kunden oder der Öffentlichkeit in einem besseren Licht erscheinen lässt. METR und Co. mögen zwar nahe an der Branche sein, doch sie dauerhaft zu embedden schafft trotzdem echte Kosten. Und ein Slowdown könnte der Konkurrenz eher helfen, als ihr zu schaden: Die Technologieführer schreiten langsamer voran, doch ihre Modelle stehen bereit, um "distilliert" zu werden, also um Nachzüglern bei der Entwicklung ihrer eigenen Modelle zu helfen (hier käme es darauf an, wie genau der Slowdown regulatorisch konzipiert ist). Zu guter Letzt laufen die KI-Firmen das Risiko, dass die hohen Finanzierungsbedarfe ihres Sektors, welche auf massiven Umsatz- und Investitionsprognosen basieren, bei einem Slowdown nicht mehr haltbar sind. Das könnte den gesamten Sektor destabilisieren. Stimmt diese Lesart, ließen sich die Aufrufe zur Verlangsamung wahrscheinlicher als authentische Sorge interpretieren, statt als reines PR- oder Wettbewerbsmanöver. Gesichert ist das nicht; das Motiv der Akteure lässt sich von außen nicht einwandfrei klären.
Das Spieltheorie-Dilemma
Wie realistisch ist ein Slowdown? Das zentrale spieltheoretische Problem ist, dass jede KI-Firma (und jeder noch so wohlmeinende Forscher darin) die Sorge haben muss, dass ein Konkurrent vorbeizieht, sobald sie das eigene Entwicklungstempo verlangsamen. Und welche Garantie hätte man, dass besagter Konkurrent so vorsichtig und fähig am alignment arbeitet, wie man es selbst vorhat? Das Resultat ist ein Koordinationsproblem: Kein KI-Akteur hat individuell einen Anreiz, die Entwicklung zu verlangsamen. Nur wenn es ihnen gelingt, sich zu koordinieren, kann es realistisch klappen.
Eine Rolle darin kann die Regierung spielen, denn sie kann koordinieren, Anreize setzen oder erzwingen. In den USA ist die Trump-Regierung allerdings ausdrücklich gegen jede Form von KI-Regulation. Das Einzige, was es an Regulation brauche, sei ein "starker und smarter (hoher IQ) Präsident", so Trump; Warnungen vor KI seien ein "Hoax" und KI-Kritiker sollten sich "in Acht nehmen". Später schien er auf die öffentliche Unruhe doch ein wenig zu reagieren und kündigte die Gründung einer "AI Force" und eines KI‑Sondergesandten an, bot aber keine weiteren Details. Trump und andere Regulierungskritiker, darunter sein "Krypto-Zar" David Sacks, verdächtigen ebenfalls, dass die KI-Technologieführer lediglich den Wettbewerb kleinhalten wollen oder ein performatives "Gutmenschentum" an den Tag legen.
Trump und andere Beobachter in den USA verweisen zudem auf China, die zweite Ebene des Koordinationsproblems. Denn so wie keine KI-Firma die andere an sich vorbeiziehen lassen möchte, so wollen die führenden USA auch nicht das nachziehende China aufschließen oder überholen lassen. Andersherum möchte China sich nicht auf einen zweiten Platz festfrieren lassen; staatsnahe Blogger erklären, dass genau das das wahre Ziel von Amodeis Aufruf sei. Ein unilateraler Slowdown ist also für keine der beiden Seiten gangbar.
Wie löst man das? Das Trump-Problem ist umgehbar, insofern die KI-Firmen sich selbst koordinieren. Laut Insidern halten Anthropic, OpenAI und Google regelmäßige Gespräche über die Bildung eines Branchenkomitees ab – und diskutieren, auch ohne Unterstützung der US-Regierung voranzuschreiten. Dass die Regulation einer derart wichtigen Technologie wie KI und des zugrundeliegenden Koordinationsproblems vollständig innerhalb der Branche liegt, dürfte bei vielen Beobachtern zu nachvollziehbarer Skepsis führen. Die einzige Alternative wäre, dass die US-Regierung doch noch einschreitet, z.B. nach einem Regierungswechsel oder nach wachsendem öffentlichen Druck. Andere westliche Länder sind in Anbetracht ihrer Zweitrangigkeit in der Modellentwicklung auch in der Regulierungsfrage sekundär; sie können erst dann wirkend werden, wenn die US-Regierung oder die KI-Firmen freiwillig zu internationaler Koordination schreiten.
Das China-Problem ist schwieriger lösbar. Washington und Peking planen zwar Gespräche, doch Resultate sind nicht absehbar; offenbar herrscht nicht einmal Einigkeit darüber, worüber genau gesprochen werden soll. Einige Beobachter wie der Ökonomie-Blogger Noah Smith und der China-Analyst Kyle Chan empfehlen, Peking aufzuzeigen, dass bereits die heimischen chinesischen Modelle imstande seien, die Dominanz der Kommunistischen Partei zu gefährden – zum Beispiel mittels Cyberangriffen anhand chinesischer KIs. Das würde China natürliche Anreize dafür verschaffen, sich mit den USA bei einem Slowdown zu koordinieren, um noch größere Risiken durch noch fähigere KI-Modelle zu vermeiden. Dazu passt, dass Chinas Geheimdienstchef Chen Yixin in einem Artikel jüngst genau davor warnte: dass KI eine direkte Gefahr für die Herrschaft der Kommunistischen Partei darstelle (allerdings scheint er sich vor allem auf Gefahren durch amerikanische Modelle zu beziehen). Parallel könnte es helfen, die westliche Verhandlungsposition gegenüber China zu verbessern, z.B. durch noch robustere, stärker durchgesetzte Exportsperren auf KI-Chips.
Ein Fazit_
(2 Minuten Lesezeit)
Große Gefahren
Was bleibt? Die Sorgen vor existenziellen Katastrophenszenarien sind theoretisch durchaus fundiert, doch sie sind bislang auch völlig hypothetisch. Zumindest auf Basis von allem, was aktuell öffentlich bekannt ist, existiert noch keine AGI, und sie ist auch nicht zwingend erkennbar. Dennoch ist der Verweis auf Sicherheitsrisiken und mit ihm der Aufruf zu Regulation valide: Zum einen, da bereits mit dem heutigen Stand von KI akute Risiken existieren, vor allem in der Cybersecurity; zum anderen, da das Erreichen einer AGI inzwischen deutlich realistischer geworden ist und damit plausible Katastrophenszenarien einhergehen. KI-Firmen haben in den vergangenen Monaten teils eklatante Schwächen beim sicheren containment ihrer Modelle in Testumgebungen, beim alignment und bei der Interpretierbarkeit bewiesen. Ein "Slowdown" würde ihnen mehr Zeit bieten, sich operativ besser aufzustellen – und der Gesellschaft, sich an KI-Risiken anzupassen.
Der von einigen KI-Firmen geforderte Slowdown ist damit sinnvoll und die vorgeschlagenen Schritte ebenso, nur sind sie bislang äußerst vage. Basiert der Slowdown auf freiwilliger Koordinierung durch die KI-Firmen selbst, dürfte das bei Beobachtern zudem tiefe Skepsis wecken – nicht zuletzt, da bereits jetzt Uneinigkeit im KI-Sektor herrscht. Eine staatliche Regulierung durch die Trump-Regierung ist vermutlich erst zu erwarten, wenn der öffentliche Druck steigt. Die Dynamik im KI-Wettrennen zwischen den USA und China macht derweil glaubwürdige, robuste Koordination auf internationaler Ebene äußerst schwierig. Je größer der technologische Vorsprung des Westens und je höher Peking die Gefahr durch heimische (nicht nur amerikanische) KI-Modelle einstuft, umso höher die Chance auf eine koordinierte Lösung – insofern sich die US-Regierung ebenfalls dazu öffnet.
... und große Chancen
In all dem sollte nicht außer Acht gelassen werden, dass KI beträchtliche Chancen für die Menschheit mit sich führt. Es ist denkbar, dass sich die Welt derzeit in den 1870ern befindet: in den frühen Tagen einer jahrzehntelang währenden Phase an tiefgreifendem technologischem, wirtschaftlichem und gesellschaftlichem Umbruch, aus welcher sie wohlhabender, gesünder und mit mehr Wissen herausgeht. Ein völliger Stopp der KI-Forschung ist damit weder erstrebenswert noch realistisch. Notwendig ist eine Ausbalancierung, welche in dieser Phase der Technologie zu mehr Vorsicht neigen sollte.
Dazu passt ein Zitat des ungarisch-amerikanischen Mathematikers John von Neumann, einem der renommiertesten Forscher der Weltgeschichte, welcher ebenfalls am Manhattan Project beteiligt war. In seinem Essay "Can We Survive Technology?" aus 1955 schrieb er: "Für Fortschritt gibt es kein Gegenmittel [...] Die einzige Sicherheit [...] besteht in einer Wachsamkeit gegenüber der Zukunft sowie in einer klugen Ausübung des täglichen Urteilsvermögens." Anders als sein Kollege Joseph Rotblat trat Neumann nie vom Manhattan Project zurück, sondern leitete später noch die Entwicklung einer Wasserstoffbombe.
Weiterlesen
Explainer zu KI
Die USA und China im "Kalten KI-Krieg" (2026)
Was ist eigentlich ein Rechenzentrum? (2026)
Der historische SpaceX-Börsengang (2026)
Das Jahr der Mega-IPOs (2026)
Anthropic: Was macht die KI-Firma aus? (2026)
Steckt die KI in einer Blase? (2025)
Der Krieg um Talente in der Künstlichen Intelligenz (2025)
Das Internet der Zukunft (2025)
Was bedeutet KI für die menschliche Intelligenz? (2025)
Wie steht es um die Adoption von KI? (2024)
Die Vergangenheit, Gegenwart und Zukunft der Künstlichen Intelligenz (2023)
Apple am entscheidenden Moment (2024)
Nvidia auf dem Gipfel (2024)
OpenAI und der Streit um die Zukunft der KI (2023)
Explainer zu anderen Technologien
(Xeno-)Transplantationen: Was ist der Stand? (2025)
Die Zukunft der Atomenergie: Small Modular Reactors (2024)
Novo Nordisk und das Ende der Adipositas (2024)
Arm: Der wichtigste Chipdesigner der Welt (2023)
Die Zukunft der Atomenergie: Die Endlagerung (2023)
Das Ende der Atomenergie (2023)
Die Weltraumindustrie und der Staat (2022)
Die Privatisierung der Raumstationen (2021)
Die Chipindustrie und die Juwelen der Moderne (2021)
Die goldene Ära der Cyberunsicherheit (2021)
Future of Food (2021)
Explainer zu einzelnen Unternehmen
Der historische SpaceX-Börsengang (2026)
Anthropic: Was macht die KI-Firma aus? (2026)
Rheinmetall in der neuen Ära (2026)
DefenseTechs: Die neue Generation der Rüstungsfirmen (2025)
Berkshire ohne Buffett (2025)
TikTok: Gefahr oder Schreckgespenst (2025)
Wird die Commerzbank gekauft? (2024)
Die Krise bei VW (2024)
Novo Nordisk und das Ende der Adipositas (2024)
Apple am entscheidenden Moment (2024)
Nvidia auf dem Gipfel (2024)
OpenAI und der Streit um die Zukunft der KI (2023)